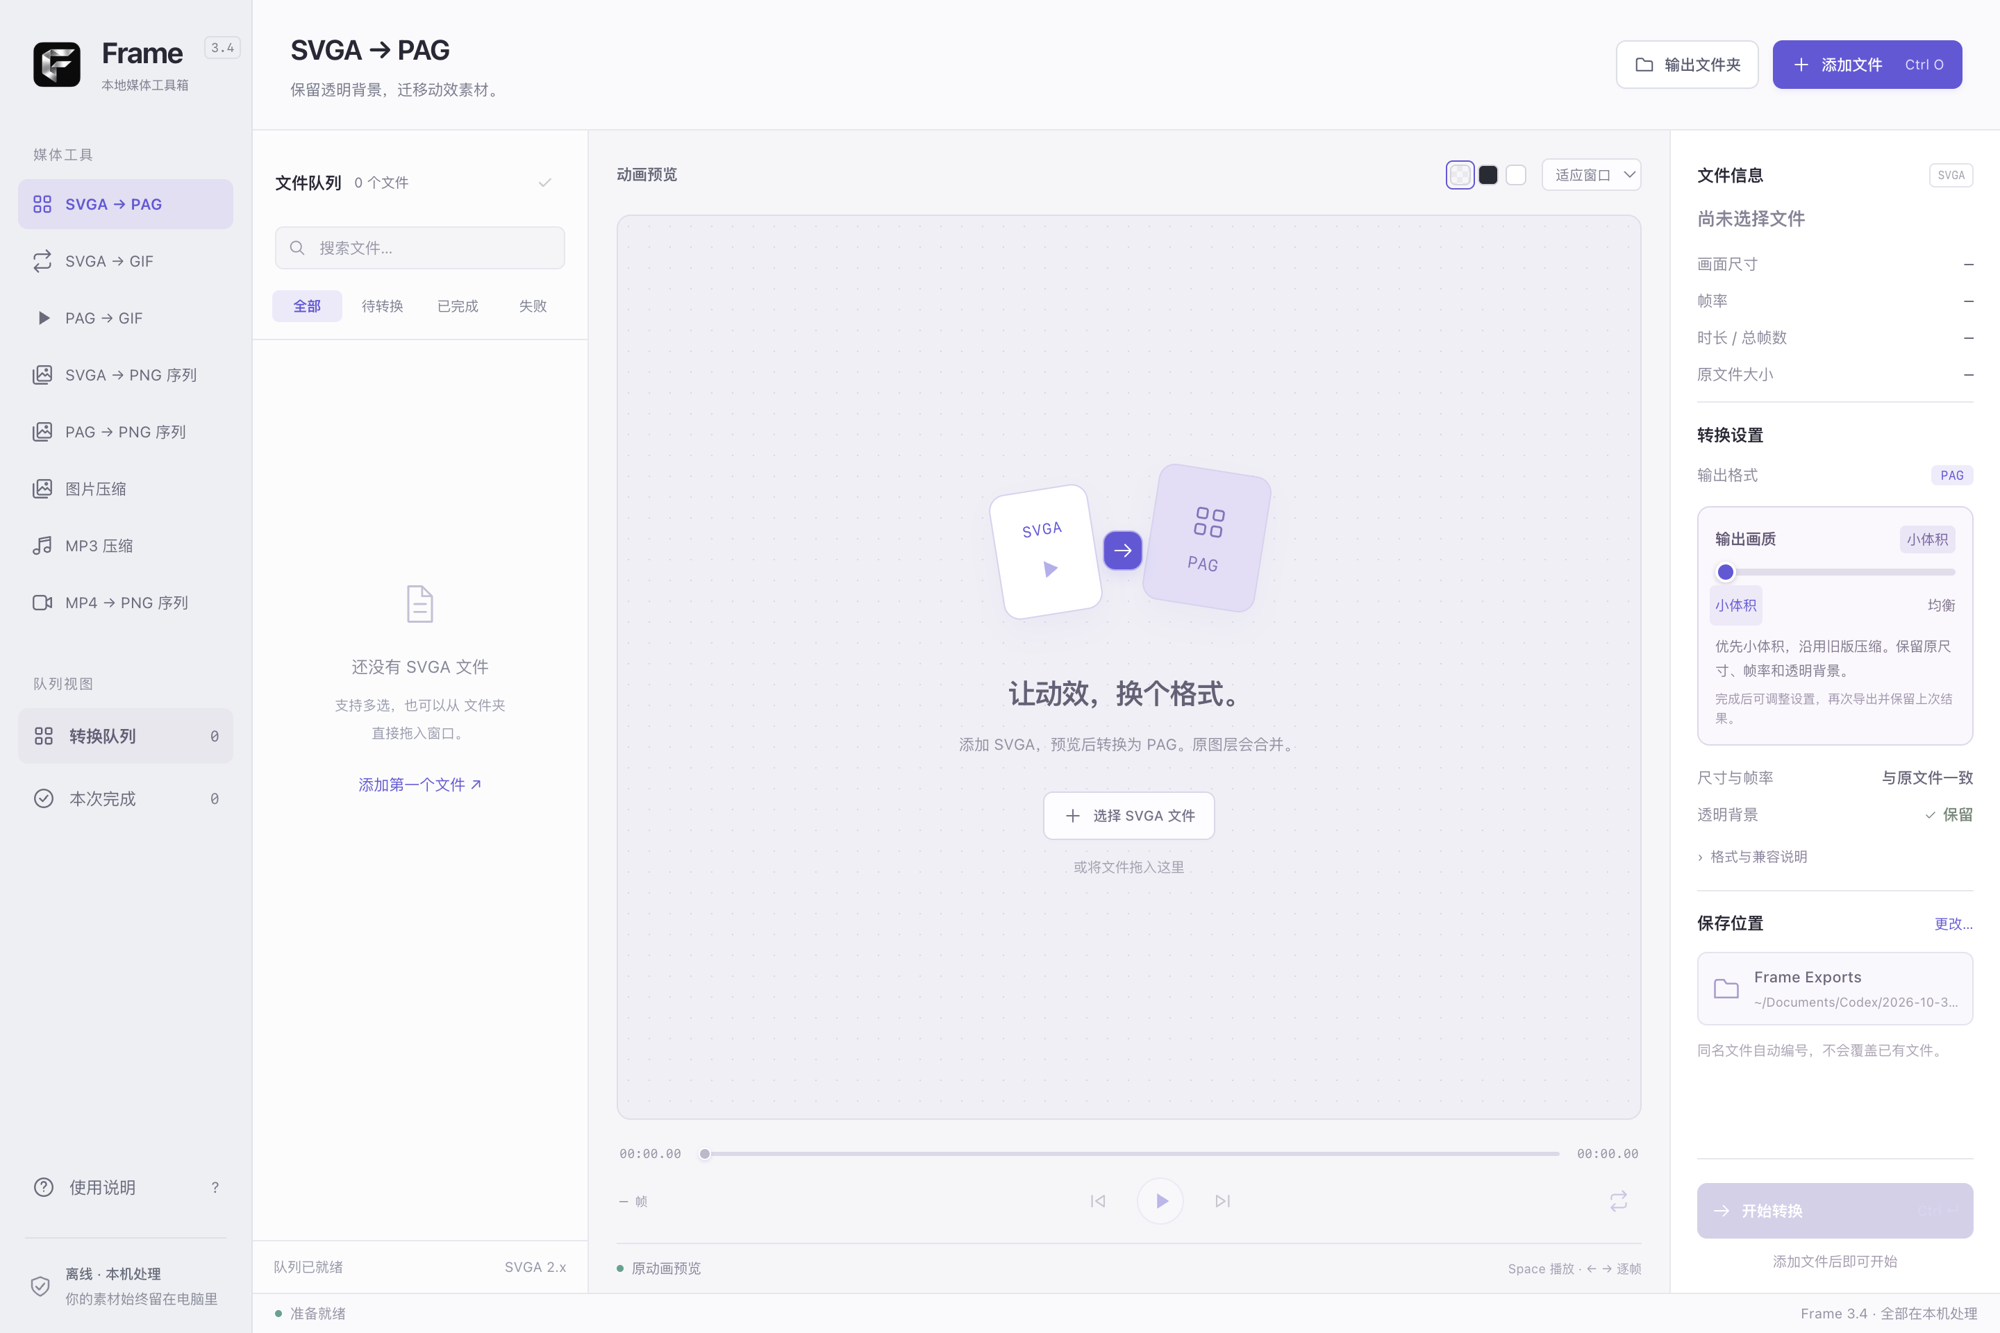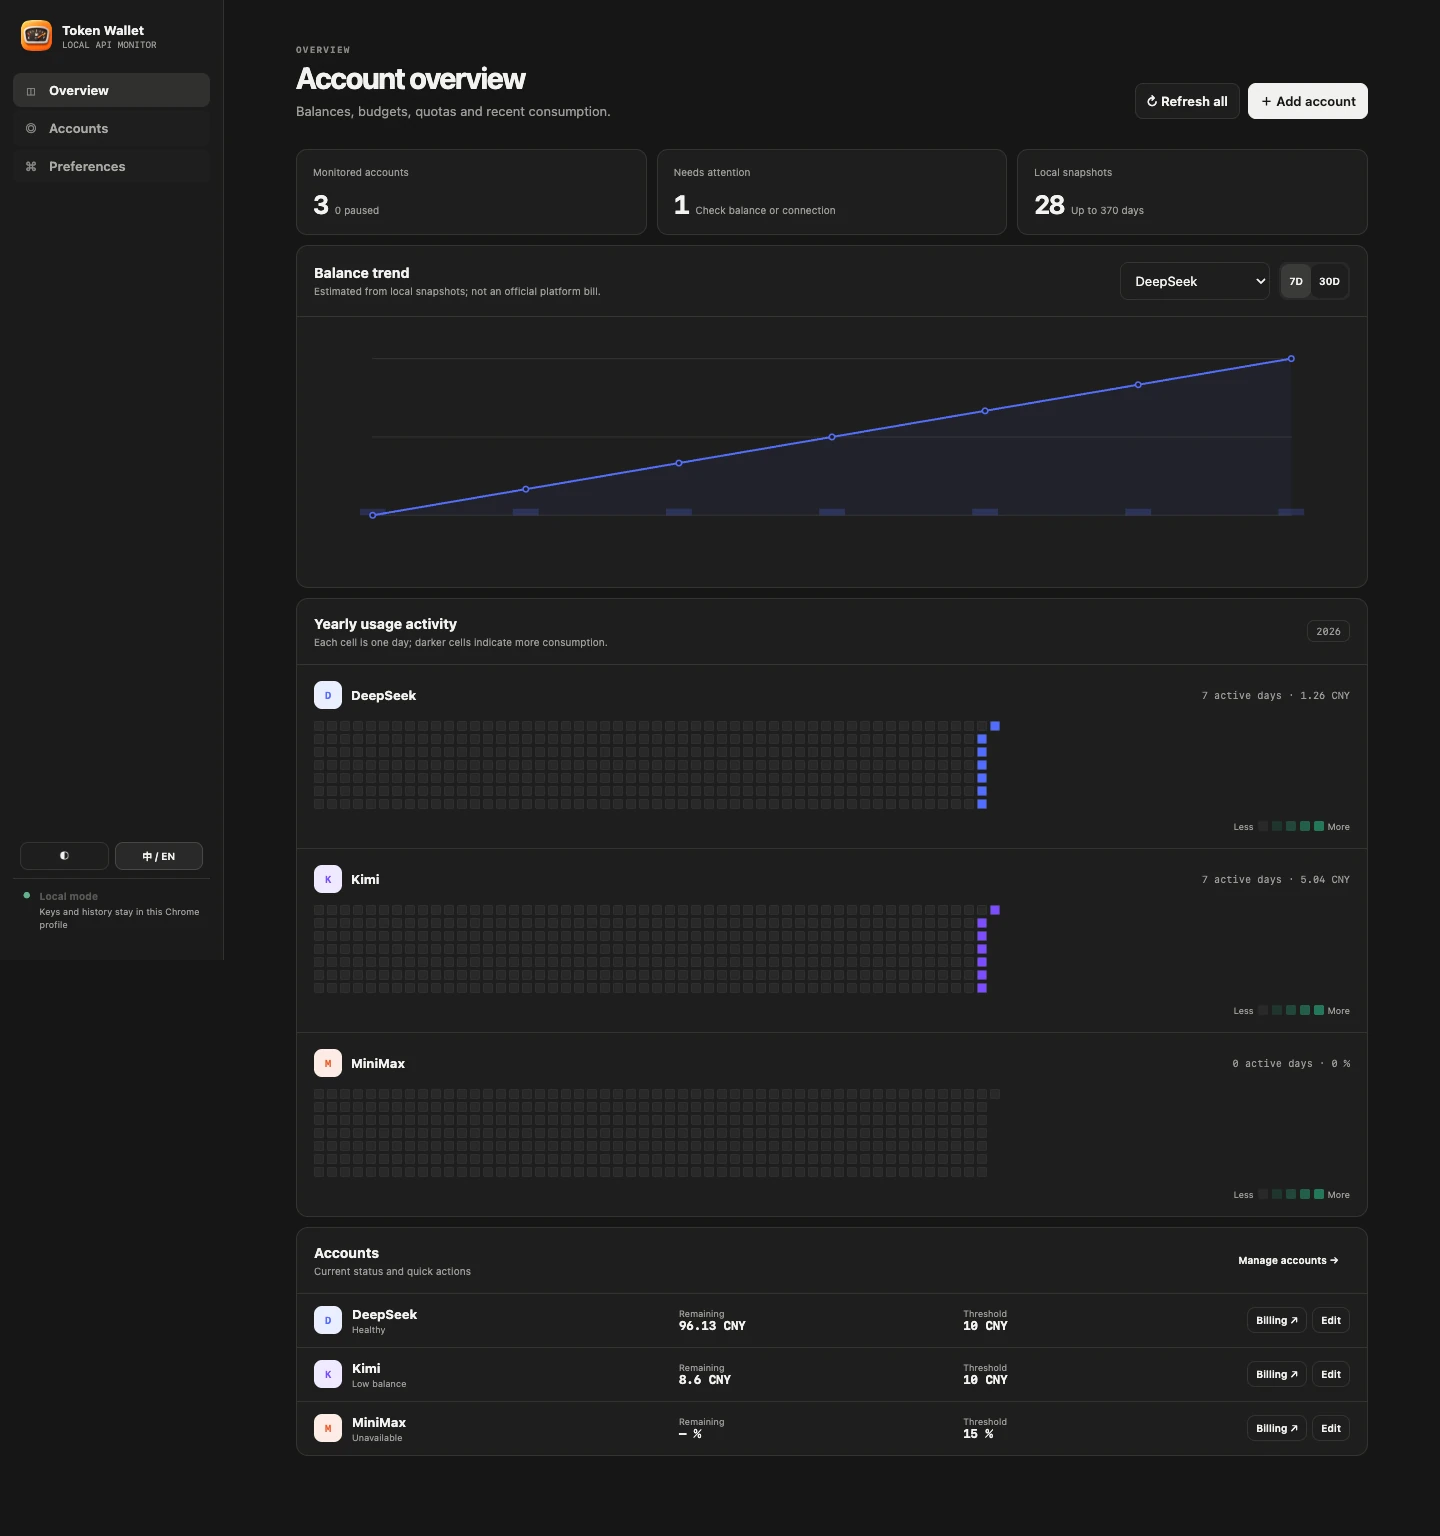
最初的工作,是听懂一份材料。
早期 Tandu 围绕文章导入、分句朗读、暂停追问与继续收听形成闭环。问题随后延伸到理解之后:用户还需要会议纪要、学习笔记、初稿或行动项,不应为每一种成果重新复制同一份材料。
从伴读到工作台,迁移的不只是名字。
KnowFlow 把原文、问答与成果留在同一份材料的上下文里。品牌迁移同时保留旧账号、历史材料、配置、备份与启动入口,避免新产品定义以丢失用户原有工作为代价。
一个来源,可以形成不同的工作成果。
- 01导入材料
文章、文本或音频进入材料详情。
- 02理解与追问
围绕原文段落提问,并保留引用关系。
- 03生成成果
不同工具使用各自参数,形成独立成果。
- 04编辑与复用
结果可以继续编辑,不把生成视为终点。
AI 的答案,需要能回到具体原文。
实现中保留原文段落编号、来源哈希与引用编号校验。点击引用可以回到原文,相关音频可以定位,问答还能存为笔记。这使“生成一段可信的话”进一步变成“有机会检查依据”。
长音频:失败、费用和重试要一起设计。
| 问题与场景 | 处理方式 | 取舍与依据 |
|---|---|---|
| 长时处理 | 分片并在后台运行 | 让进度属于任务,不依赖一直停留在页面 |
| 部分失败 | 记录完成片段并处理退积分 | 手动重试复用已有片段,避免重复处理 |
| 服务中断 | 标记中断,要求用户明确重试 | 不把自动恢复变成不知情的重复付费 |
后台任务不能覆盖用户刚写下的内容。
转写进行时,用户仍可能修正原文。实现使用文档版本检查拒绝陈旧的全文写入;任务结果与当前原文不一致时,需要确认,而不是直接替换。测试文件也保留了旧引用与陈旧写入的对应场景。
多平台配置,不只是一个模型下拉框。
内容生成、转写与朗读分开配置;保存设置不调用模型,连接测试才可能产生服务费用。修改 API 地址需要重新填写密钥,避免旧凭据随新地址被发送。当前多模态模型入口仍以文本处理为限,不扩写成已完成图片或视频理解。
交付与复盘
交付物
项目记录
已有验证记录
历史 QA 文档记录 59 项通过,并用合成音频和模拟供应商检查分片失败、退费、重试与 390/1280 布局。这是历史受控验证记录,不代表本轮重跑或真实服务质量验收。
从 Tandu 到知流,变化的不只是名称,而是产品边界:从消费信息,走向形成自己的成果。